Harvey 的 Agent 架构:加能力,不加 Agent
中文 · 技术学习 · 2026年10月
一家法律 AI 公司,平台上跑着 25,000 多个 custom agent。撑起这一切的不是一堆专业 agent,而是一条规矩:不准自己写编排。
TL;DR
- 先定目标,再定规矩。 Harvey 的三条架构原则,是从三个目标倒推出来的:质量随模型变强、功能之间能组合、不靠一个中心团队。
- Tool Bundle 是核心抽象。 一个 agent 只是「system prompt + 一组 bundle」。功能越多,bundle 越多;agent 本身没几个。
- Harvey 选 OpenAI 的 Agent SDK,恰恰因为它不支持 workflow 式编排。代价是丢了确定性,换来的是所有能力都能组合。
- 60 多个司法管辖区、400 多个数据源,背后是一个 agent 加一组参数化的 tools。他们明确否决了「每个管辖区一个 agent」。
- 我觉得最值得抄的是 eval 门禁:路径可以不确定,产出必须确定。
一、先把「agent」这个词说清楚
Harvey 给了一个四层的概念栈。我特别喜欢它,因为「agent」这个词已经被用烂了。
Layer 4: Workflow
  一个或多个 agent 协作,产出具体的 work product
  "Agents are the means; workflows are the ends."

Layer 3: Agent
  Model System + Plan + Adapt + Interact
  会拆任务、会根据中间结果改计划、会主动向人要信息

Layer 2: Model System
  多个模型 + 工具 + 知识源,线性、刚性的流程
  步骤预设、顺序固定,不会因为中间结果改变路径

Layer 1: Model
  单个模型,给 prompt 出 response
Harvey 对 model system 的形容是 “rigid one-way trips”:一条道走到黑。Agent 则是 “model systems that can plan, adapt, and meaningfully interact with humans”。
所以每次有人说自己做了个 agent,我只问两个问题:
- 它会不会因为中间结果改变执行路径?
- 它会不会主动问你要信息?
两个都不会,那就是一条 pipeline。挂了再多 tools 也一样。
很多所谓的 agent,其实是带了 tools 的 pipeline。
二、三个目标,倒推出三条规矩
这是我读完最想推荐的一个习惯:Harvey 不是先选了架构再找理由,而是先写下目标。
| 目标(Harvey 的原话大意) | 推出的原则 |
|---|---|
| 输出质量随时间变好:把模型的能力用到极致 | No Custom Orchestration:不准自己写编排,交给模型的 tool-calling loop |
| 新功能之间能互相配合:检索、起草这些能力要天然能组合 | Capabilities are Tool Bundles:所有新能力都打包成 bundle |
| 不依赖中心团队:一个团队包揽所有新能力,功能开发就扩展不了 | Eval Gates:每个 bundle 配一套离线 eval,上线前过门禁 |
后面每一个具体决定,都能对回这张表。
架构原则不是品味,是目标的推论。
三、Tool Bundle:能力的最小单元
先看问题:一个对话框,事先不知道该走哪条路
Harvey 的 Assistant 是一个对话线程:律师在里面提问,系统在同一个线程里完成检索、起草和审阅。难点在于,同一个对话框里,正确的做法可能完全不同。Harvey 举了三个例子:
- 先多次查一个税法数据库,再拿结果对照最近的新闻
- 写长文档写到一半,去客户的 Vault 里拉资料补其中一节
- 在文档审阅表里加几列,再把这几列汇总
系统事先不知道要走哪条路。
最早的做法是 Assistant 团队写 Python 加 LLM 调用,每个功能是一段定制流程,再靠「模式」分流:要起草,切到 Draft mode;要查知识源,界面给你推荐。别的团队只能往里加检索类的知识源。然后撞了三堵墙:
| 层面 | 撞到的墙 |
|---|---|
| 产品 | 用户发现不了 Draft mode |
| 工程 | 多路检索藏在同一个界面后面,越来越难维护 |
| 协作 | 别的团队做的新功能(比如 Ask LexisNexis)找不到上线的路 |
2025 年年中,Harvey 改成纯 agent 架构:所有功能都变成 tool,让模型自己决定调什么。新问题马上出现:每加一个能力,都要在主 system prompt 里写一段「这个能力怎么用」。最初的设想是 “One team owns the system prompt, one owns the tools.” 结果每个新功能都要排队等 prompt 团队改;多个工程师改同一份核心指令,还会互相踩脚。
Tool Bundle 是什么
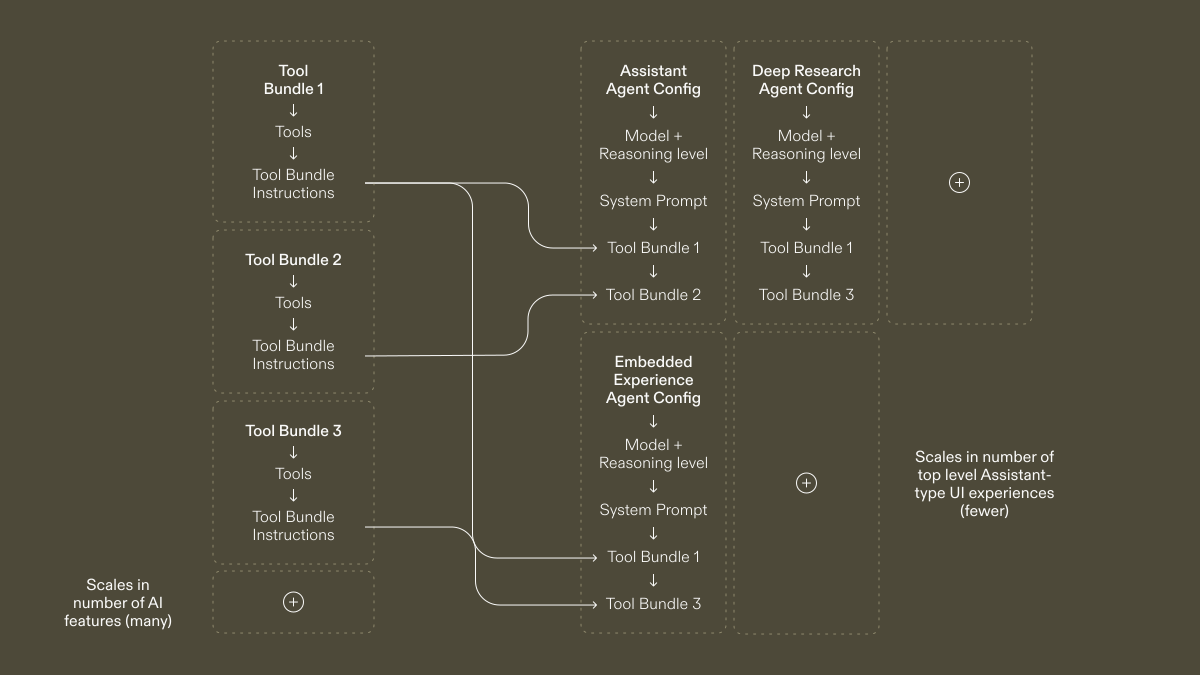
Tool Bundle 是 Harvey 设计的一个接口:开发者把一个能力打包成一个单元。按 Harvey 的定义,单元里只有两样东西:
- 一个或多个 tool,也可以是 sub-agent
- 一段 instructions,教模型怎么组合使用这些 tool。这段话会被注入主 agent 的 system prompt
Harvey 举了两个例子:文件系统 bundle 是一个类似 grep 的搜索、一个打开文件的 tool、一个语义搜索,加上教模型怎么配合使用它们的说明;起草 bundle 是一个编辑 tool 加一个起草 sub-agent。
一个 agent 又是什么?“An agent at Harvey is composed of a system prompt and a set of Tool Bundles.” 可以把 agent 想成宿主程序,bundle 是插件:每个插件自带功能,也自带说明书。看上面这张图,右边每一列就是一个 agent 配置:选哪个模型、多高的 reasoning level、什么 system prompt、接哪几个 bundle。图上的两行标注说得很直白:bundle 随 AI 功能的数量增长(很多),agent 配置随产品入口的数量增长(很少)。
有一件事不在 bundle 里:eval。 每个 bundle 配一套离线 eval,包括数据集、evaluator 和报警阈值,由这个 bundle 的 owner 维护。它只在改 prompt、加 bundle、准备上线的时候跑,agent 运行时用不到(第七节细说)。
它解决了什么
产品上,用户不用再挑模式。起草变成 agent 能调用的一个能力,律师直接说要什么就行;能力之间也能互相组合,比如起草写到一半,顺手去 Vault 查资料。
组织上,功能团队可以把自己的 instructions 写进主 system prompt,“without needing to make a request of the Assistant team”。同一个 bundle 还能接进不同的 agent,就是图里 Tool Bundle 1 那三根线。
Harvey 自己说,最重要的一条理由是:“Most importantly, Tool Bundles allow us to apply leave-one-out validation gating on key benchmarks.” 能力有了边界,才能一个一个拿掉来测。
备选方案和代价
| 做法 | 好处 | 代价 |
|---|---|---|
| Assistant 团队包揽所有功能(单体) | 一个团队管,指令不打架 | 团队成为瓶颈;用户找不到各种模式。Harvey 明确否了:目标是让别的团队贡献集成,“rather than relying on our team to integrate it into a monolithic system” |
| 一个团队管 prompt,一个团队管 tools | 分工清楚 | 试过,失败了:每个新能力都要改 prompt,prompt 团队又成了瓶颈 |
| 每个功能做成独立的 agent | 互不干扰 | 这篇没讨论。知识源那篇否掉了「每个管辖区一个 agent」,理由是 agent 之间交接会丢对话历史;我的理解是同样的问题也适用这里 |
| Tool Bundle(实际选择) | 团队自主上线、能力可组合、可复用、可单独测试 | 指令双向打架、context 被塞满、组合测不完、每个团队要维护自己的 eval(第七节) |
我的理解是,Tool Bundle 本质上是分权。 System prompt 只有一份,Harvey 把它的写权限按能力切成小块,分给各个团队。好处是谁都不用排队;代价是这些小块会互相干扰,而且它们之间唯一的隔离是自然语言,编译器帮不上忙。
「从一个团队变成四个」是什么意思
Harvey 的原句是:采用统一的 agent 框架后,“in-thread feature development” 从一个团队扩展到了四个。意思是,能在 Assistant 对话线程里开发并上线功能的工程团队,从只有 Assistant 团队一家,变成了四家。
哪四个,原文没说。同一篇文章提到了 Ask LexisNexis、iManage 这样的集成和 Deep Research 这样的产品模式,所以可以猜:一个是 Assistant 团队,其余负责这些集成和模式。但这只是推测。
4 也不是设计目标,而是博客发表时(2025 年 11 月)的结果。重点在方向:从「只有中心团队能加功能」,变成「多个团队并行加」,正好对上第三个目标。这也是 Harvey 公开的唯一一个扩展数据,开发速度方面没有任何数字。
分出去的权限,要靠 eval 门禁收回来。所以 Tool Bundle 从来不单独出现。
四、限制即特性:故意选一个不能编排的 SDK
这是整套设计里我最佩服的一个决定。
Harvey 选 OpenAI 的 Agent SDK,理由是和别的框架比,它 “explicitly left out an option to orchestrate code in a more ‘workflow’ type format”。
一般人选框架,看的是它能做什么。Harvey 看的是它不能做什么。
| 方案 | 好处 | 问题 |
|---|---|---|
| 各团队自己写编排(当时的做法) | 离单个产品目标最近 | 很快长成同一张 “web of routing and human decision-making”,违背目标一和二 |
| 自己写一个 agent 框架 | 完全可控 | 原文没展开;我的理解是:又多一个要中心团队维护的东西 |
| 选一个带 workflow 编排能力的框架 | 灵活 | 留了后门,团队还是会回到写死流程 |
| 选一个不支持 workflow 编排的 SDK | 逼所有能力都变成「在 loop 里调 tool」 | 丢掉执行顺序的确定性 |
代价是真的。 一个具体例子:case law research 原来是写死的两步,先查用户的文档,再拿结果去查最新判例。改成 tool loop 以后,Harvey 承认:“we couldn’t guarantee determinism in execution for the case law product”。
怎么判断值不值。 他们看了两件事。一是质量没掉:调过的 prompt 让 tool recall 依然很高。二是收益立刻兑现:遵守框架以后,这个产品马上就能和其他知识源、Deep Research 组合起来。
怎么落地。 新代码一条硬规矩:“All new product features that live in Assistant are Tool Bundles, and every top-level thread interface is an agent.” 老功能没有一次性重写:forced retrieval call 变成 tool call,新集成变成 tool call,定制的编辑逻辑也变成 tool call,再靠一个不断长大的 system prompt 串起来。
老功能不迁过来,就没法和新功能组合。组合能力本身,就是迁移的引力。
一个值得注意的细节:「不准自己写编排」管的是 Assistant 里的功能。Workflow 那一侧,Harvey 仍然有一个 Workflow Engine(第六节有图)。我的理解是:workflow 是给用户的确定性「目的」,Assistant 里的 agent 是自由组合的「手段」,两层各守各的规矩。
五、一个 agent,一组参数化的 tools
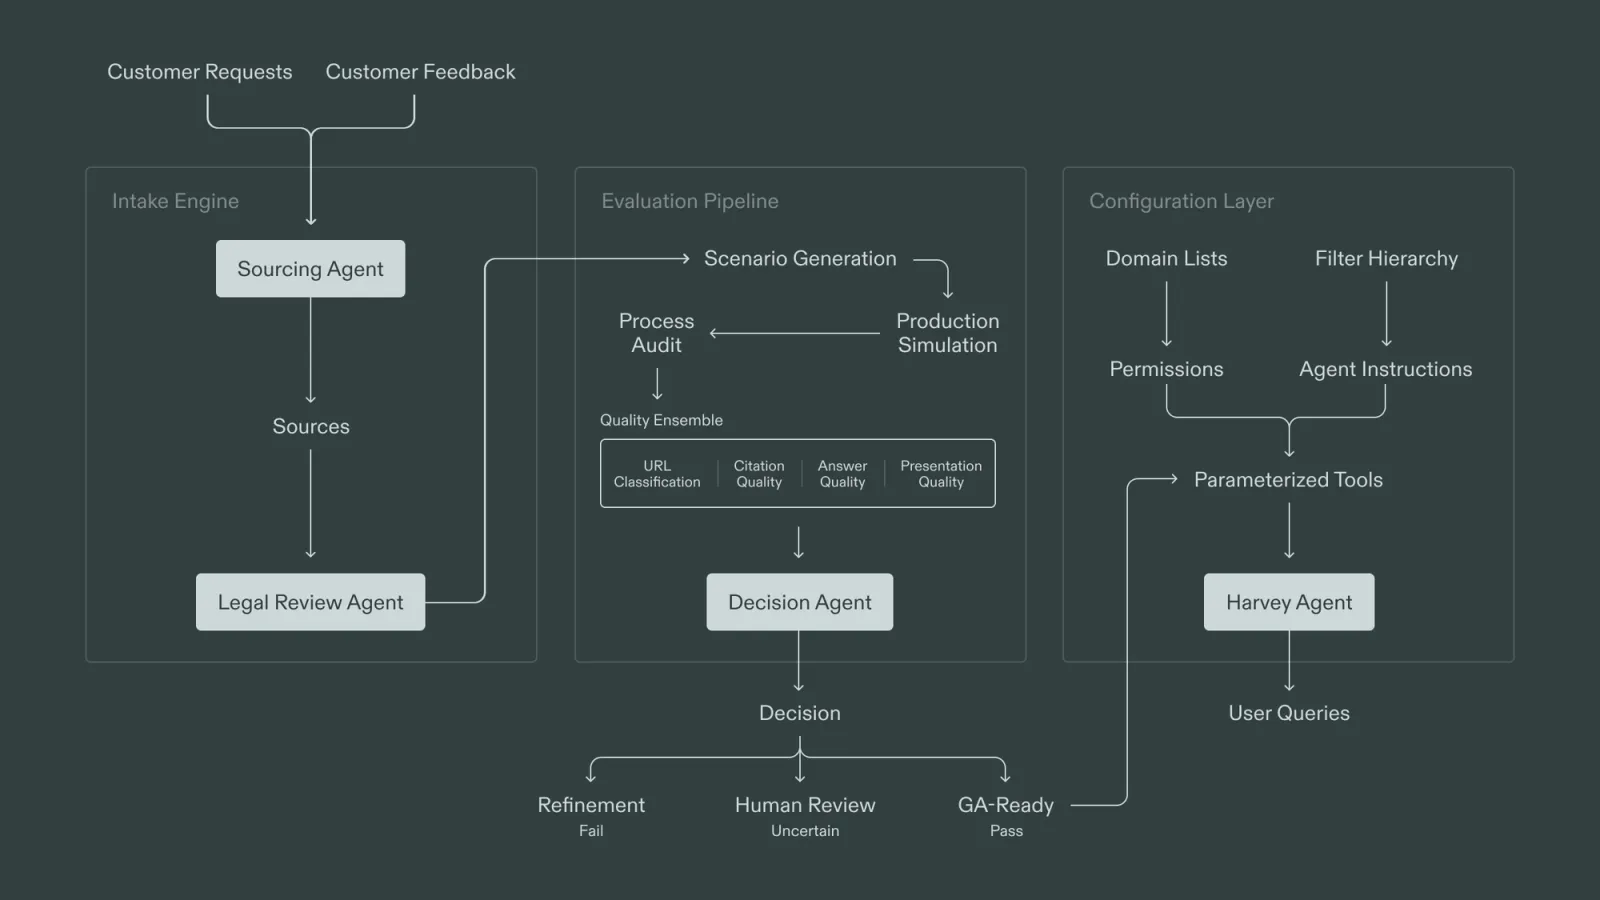
Harvey 的知识源从 6 个司法管辖区扩到了 60 多个,从 20 个数据源扩到了 400 多个。
每个管辖区只是一个声明式的配置:搜哪些域名、怎么逐层过滤、需要什么权限、可选的 agent instructions。配置变成参数化的 tools,交给 “a single unified reasoning agent”。
| 方案 | Harvey 的判断 |
|---|---|
| 每个管辖区一个专门的 agent | 最自然的设计,但被否了:sub-agent 之间交接会丢对话历史,多轮法律研究会断 |
| 直接用开放的 web search | 被否了:客户在乎来源的权威性。查德国税法要的是官方指引,不是一篇刚好排名靠前的博客 |
| 以前的做法:每个新源手工接入 | 找库、写 connector、手工标测试集、再找当地律师审,每次要几周 |
| 一个 agent + 参数化 tools + 自动化评估流水线 | 接入从几周变成几天 |
代价也写在明面上。 每评估一个数据源大约要 15 万 token;律师仍然要审每一个源,只是审得更快了:从每小时 1–2 个,提高到 2–4 个。
评估流水线里有一个我很喜欢的细节。他们一开始用一般性的问题测数据源,结果 agent 直接用模型自带的知识回答,不引用文档,导致大量「假阴性」。于是改成 answer-first:先确定答案在这个源里,再出题。
最后一步是 Decision Agent 做判定。原文只说一句:“Ambiguous cases route to human review.” 也就是说,人只看拿不准的那部分,其余全部自动归类。
规模靠参数化扩展,不靠增殖 agent。人的注意力,只花在机器拿不准的地方。
六、产品这边:先合并,再透明
先把工具合到一个界面里
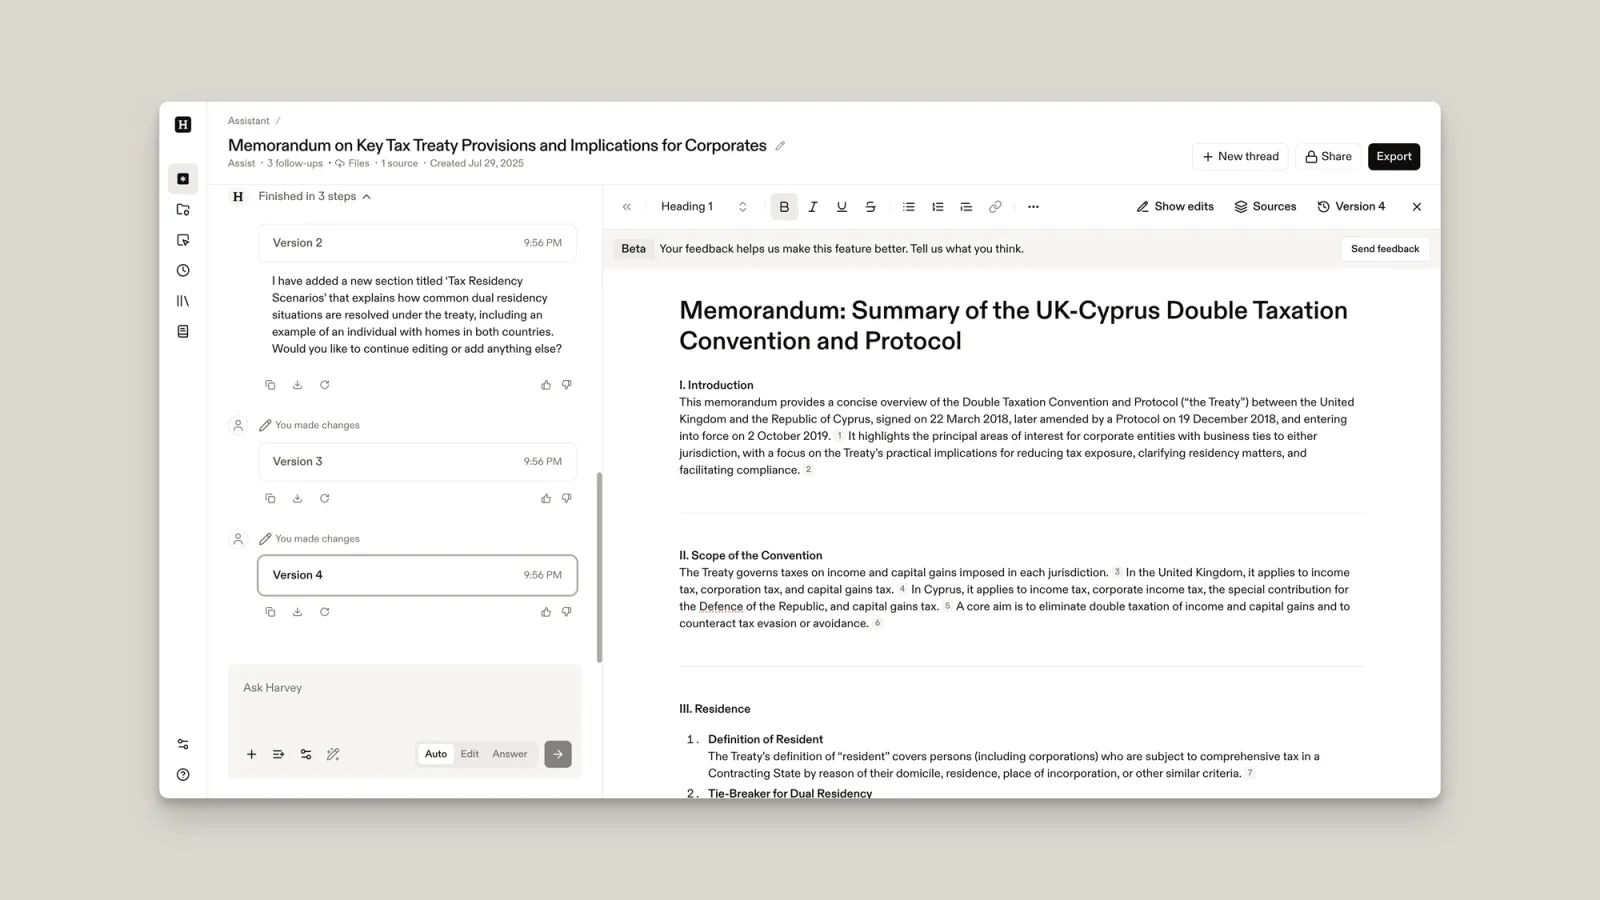
分开的工具有两个代价。一是前面说过的,用户发现不了 Draft mode。二是律师要在起草和聊天之间来回切。Harvey 的原话很干脆:“No more toggling between separate drafting and chat tools.”
背后的策略是先扩再收:“expand the platform with increasingly specific, high-value tools, and then collapse that complexity into a simple, unified interface”。合并的代价原文没提。
Agent 先出现在 workflow 里
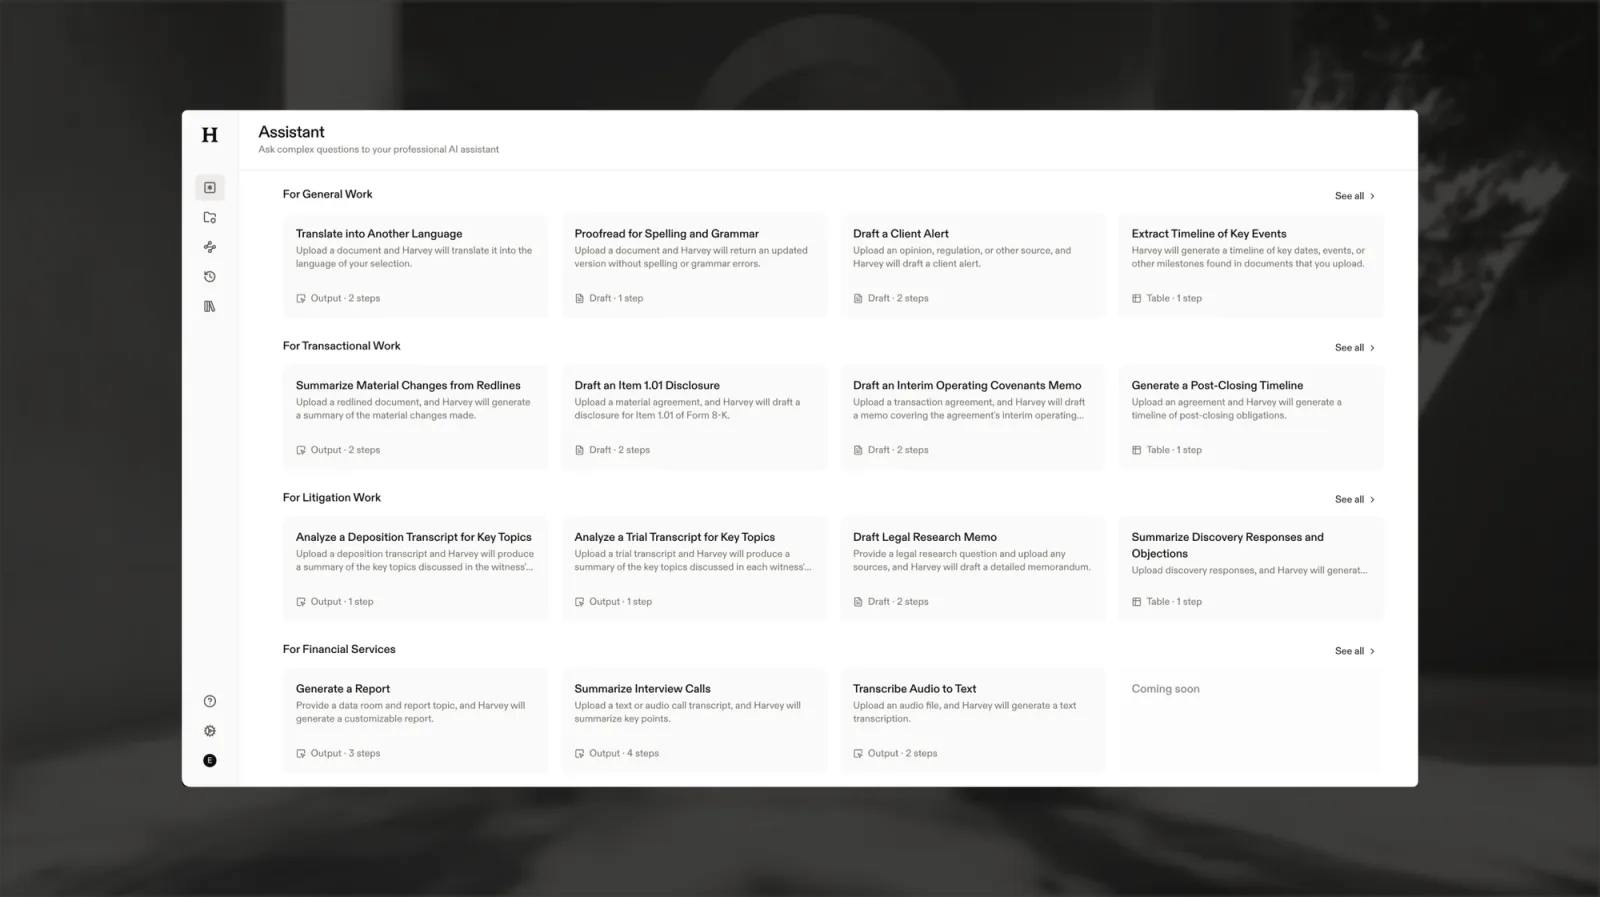
Harvey 说得很明确:“The first client-facing instantiation of agents in the Harvey platform is in workflows.” Agent 第一次面对客户,不是一个开放的对话框,而是一张张有明确产出的 workflow 卡片。
按发布时间排一下:2025 年 3 月,agent 先出现在 workflow 里;7 月合并界面、接入 Deep Research;11 月写下 Tool Bundle 原则;2026 年 2 月知识源扩到 400 多个。
我的理解是:先在确定的流程里让用户看到 agent 有用,再一点点放开自主。 这个顺序 Harvey 没有明说是策略,但时间线就是这么走的。
透明:Thinking States、澄清问题和引用
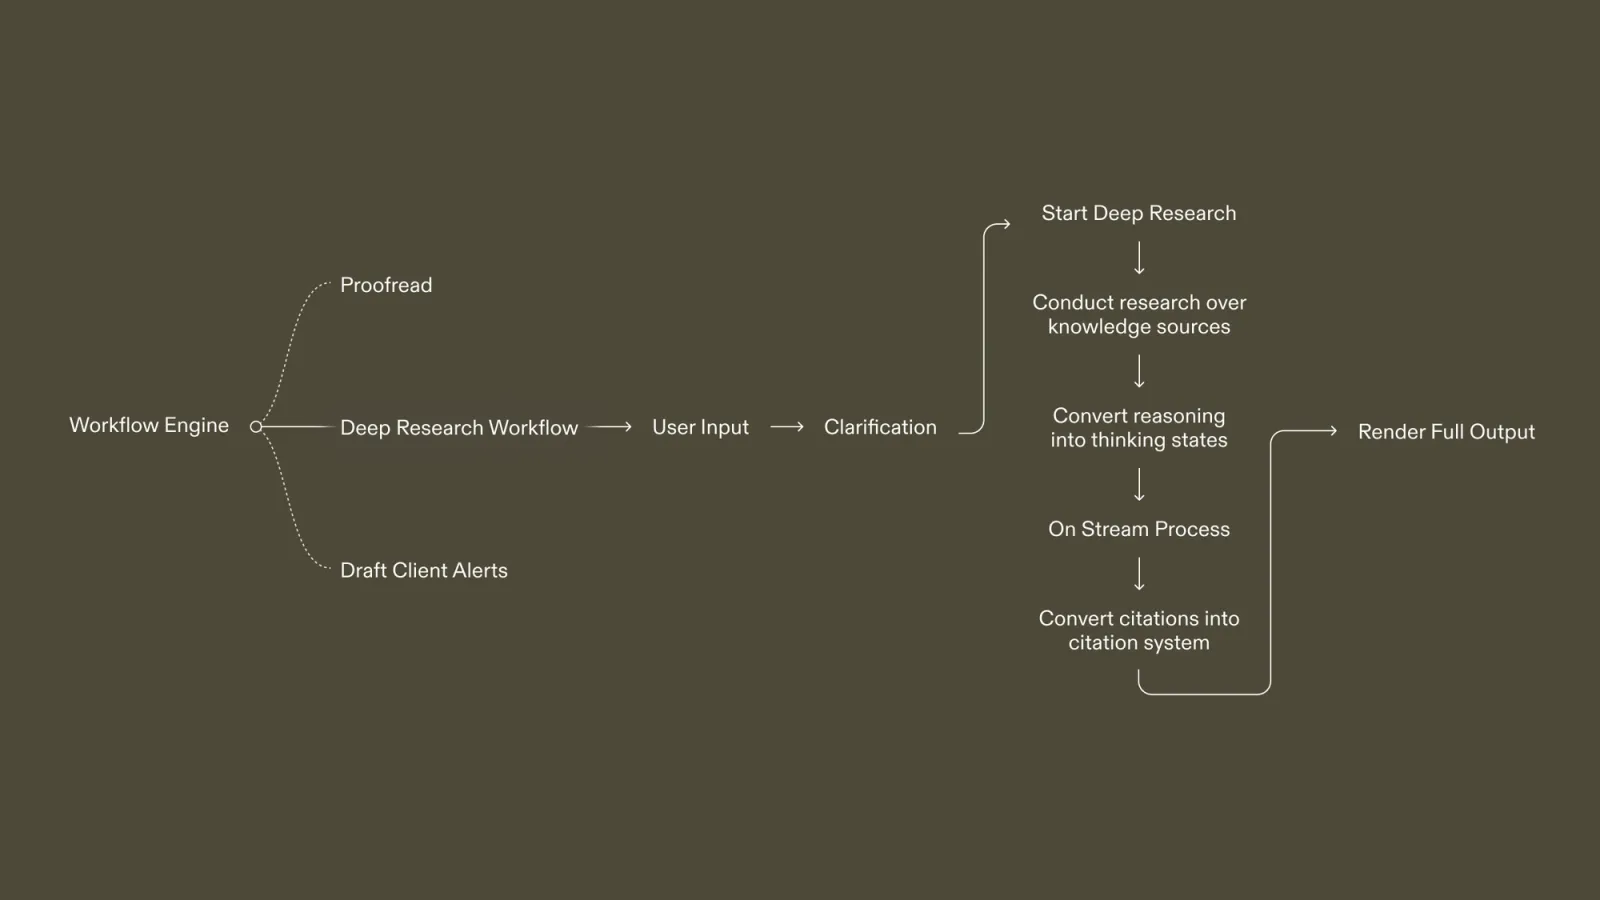
Harvey 的原则是:“A key principle for the Harvey user experience is transparency.”
落到产品上是三件事:
- 先澄清,再干活。 研究开始之前,先问用户要必要的 context。
- Thinking States。 实时展示 agent 在干什么,用户可以跟着看、随时插手。注意流程图里那一步是 “Convert reasoning into thinking states”:给用户看的不是原始推理,而是转换过的进度。
- 引用进同一个引用系统。 Deep Research 的引用被并进 Harvey 原有的引用系统。原话是:“This is essential for trust and verification in legal applications and also streamlines our development process.”
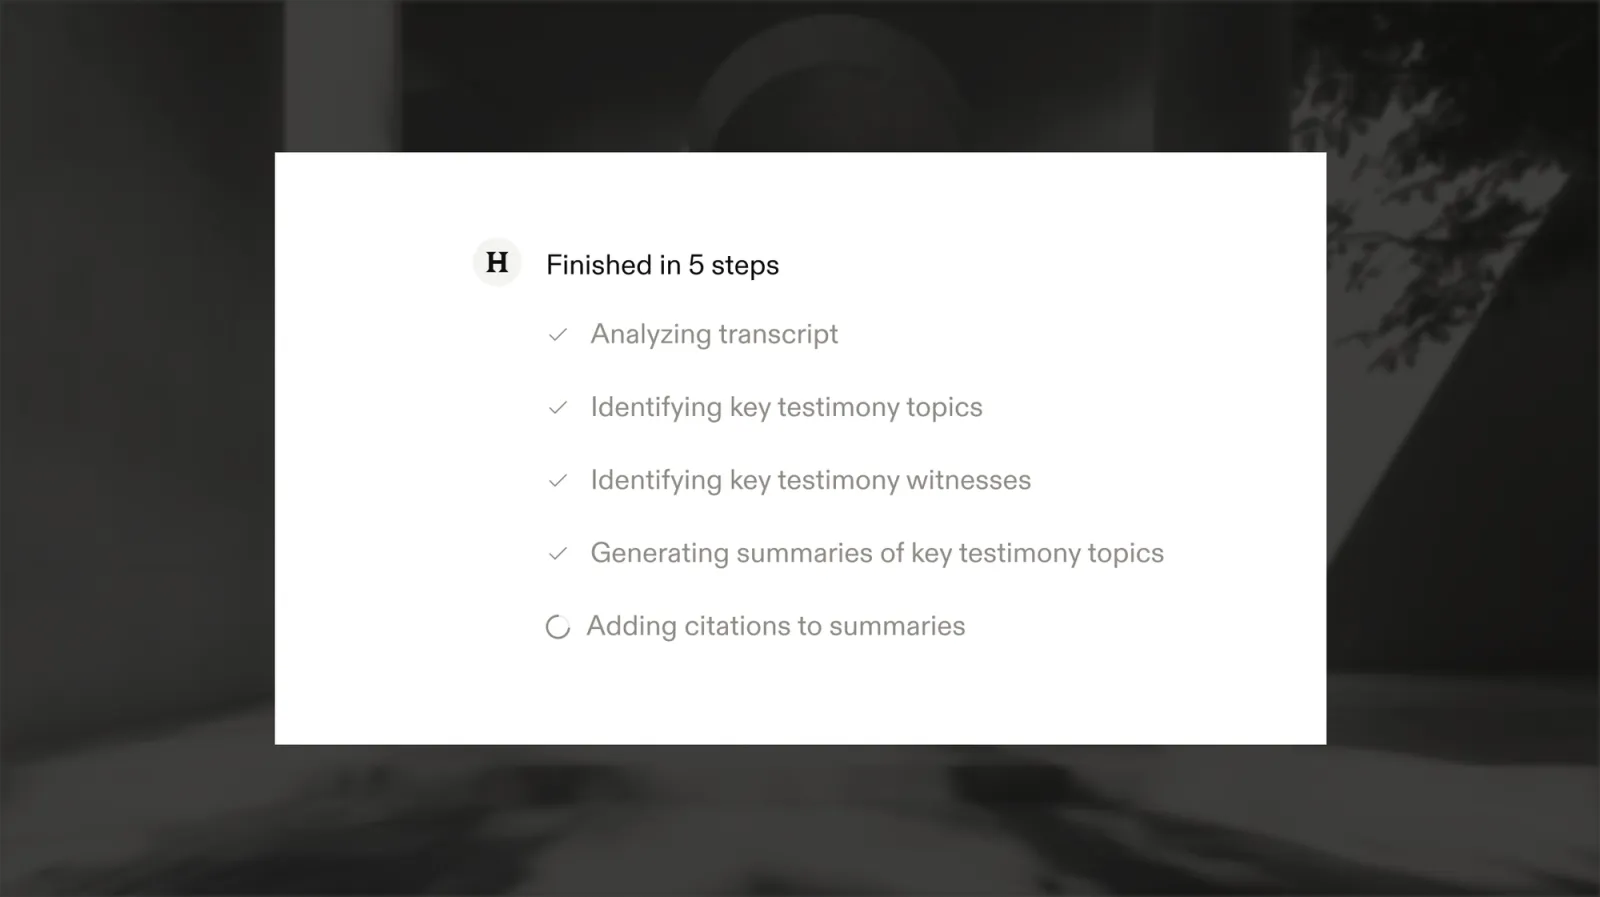
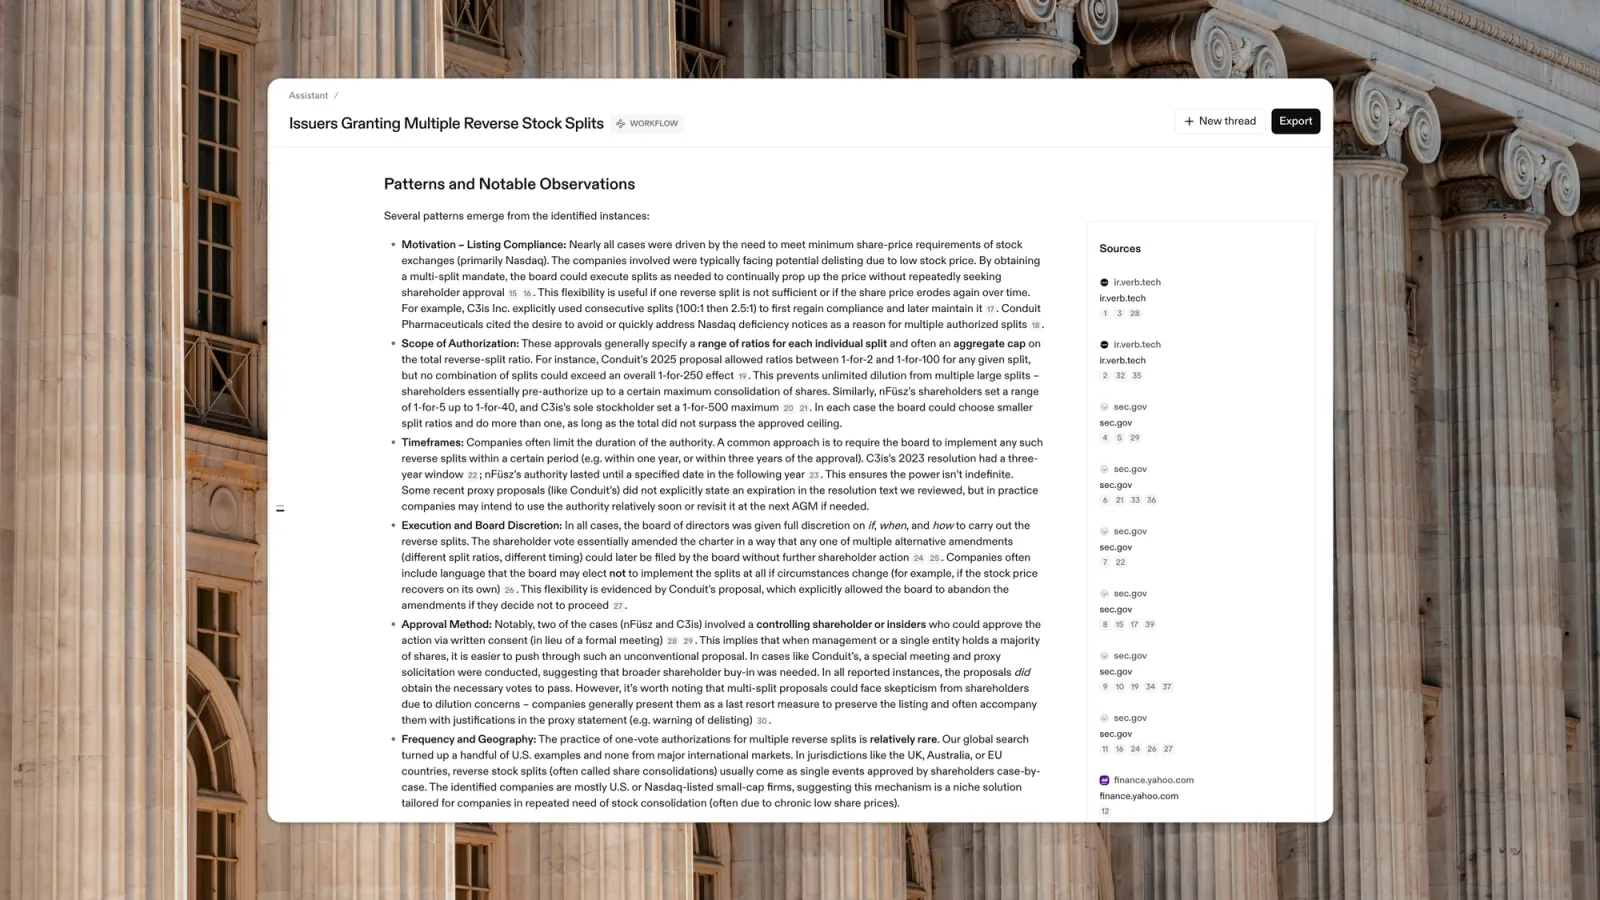
在受监管行业,黑盒等于不可用。透明不是锦上添花,是信任的基础设施。
七、Eval 门禁,和他们承认没解决的问题
门禁是离线的
先说清楚 eval 在哪里起作用:不在 agent 运行的时候,而在改动和上线之前。
每个团队为自己的 bundle 维护数据集、evaluator 和报警阈值。比如检索数据集里有大量查询,每个查询都规定了在一组知识源上期望达到的 recall。Harvey 的说法是:“When any change is made to the system, developers can verify that their capability has not regressed.” 无论是 bundle 还是 system prompt 的升级,都要先过 leave-one-out 门禁才能部署。指标掉到阈值以下,这次改动就上不了线。
三个风险,一道事后门禁
Harvey 列了「多团队往同一个 agent 里贡献能力」带来的三个风险:
- System prompt 压过 bundle:把 system prompt 的推理部分改成「尽快做决定」,模型就可能少调某些 tool
- Bundle 压过 system prompt:某个 bundle 写了「always call every tool」,模型会连别的 bundle 的 tool 也一起调
- Context rot:新 tool 返回大量内容,context window 被塞满,效果下降
对这三个风险,原文给的应对都是同一个机制,就是上面那道离线门禁:
| 风险 | 原文怎么说 | 有没有具体解法 |
|---|---|---|
| 指令打架(双向) | 列为风险,举了上面两个方向的例子 | 只能事后发现:某个 bundle 的指标掉了,门禁拦住部署。怎么避免打架、打架了怎么调,没写 |
| Context rot | 列为风险 | 没有。结尾只说正在做 “context management”,没有细节 |
| 组合测不完 | 列为待解决的问题:“how do we smartly test for a combinatorial number of Tool Bundles?” | 没有。leave-one-out 是现在的做法,原文没解释具体怎么操作 |
多个团队改同一份 prompt,冲突写不了 unit test。ZenML 的总结一针见血:“You’re no longer merging unit-testable code, you’re merging English.” ZenML 还指出了 leave-one-out 的代价:细微的退化可能漏掉。
门禁只能发现退化,不能预防冲突。
还没解决的
Harvey 自己列的待办,有两条和上面这些风险直接相关:
- 为 system prompt 和 tool 的设计总结 best practices。怎么写出不打架的 instructions,他们自己还在摸索。
- 用 reinforcement fine-tuning 提升 tool recall,“reduce reliance on prompt engineering”。我的理解是,这是从根上减少冲突的方向:把「什么时候该调哪个 tool」从 prompt 里的文字挪进模型权重里,prompt 里能打架的指令就少了。但这只是方向,没有结果。
ZenML 还补了两条批评:深度绑定一个 SDK,却没说替代方案;以及没有公布开发速度方面的数据。
所以这套插件结构的完整交代是:冲突、context 塞满和组合爆炸都会发生;离线门禁负责在上线前抓住退化;根本的解法还在做。
最难的是人
Harvey 的原话是:“The hardest part of adopting agents isn’t writing the code — it’s learning, as an engineering org, to share ownership of a single brain.”
工程师习惯了 own 自己的系统。Agent 架构要求所有人共享同一个推理系统。
这不是技术问题,是文化问题。
八、Harvey 的 Agent 和 Claude Code 有什么不一样
这一节是我自己的对比。
| Claude Code | Harvey Agent | |
|---|---|---|
| 方向 | 水平(horizontal) | 垂直(vertical) |
| 领域 | 任何代码库 | 法律工作流 |
| 用户 | 开发者 | 律师 |
| 工具 | Bash, Read, Write, Grep… | LexisNexis, iManage, 法律数据库 |
| 知识 | 通用编程知识 | 法律推理 + 60 多个管辖区 + 400 多个数据源 |
| 交互模式 | 你告诉它做什么 | 它先问清楚它需要什么 |
| 输出 | 代码、commit、PR | 法律文件、备忘录、带引用的研究报告 |
我觉得核心区别不在技术,在谁主导对话:
- Claude Code:你说 “fix this bug”,它去执行。你发起,它执行。
- Harvey:你给一个研究任务,它先澄清范围,再自己规划路径,过程透明,结论带引用。它引导,你提供 context 和判断。
这不是偶然。法律工作的核心是不确定条件下的结构化推理,律师的价值在判断力,不在打字速度。
在受监管的行业里,AI 负责提问和导航,人负责判断和确认。
九、如果你也在受监管行业做 AI 产品
我会带走这几条:
- 先写目标,再定架构原则。 每条原则都要能对回一个目标。
- 加能力,不加 agent。 能力打包成自包含的 bundle(tools + instructions),再配一套离线 eval,由 feature 团队独立 own。agent 只是配置。
- 用框架的「不能」来约束组织。 选一个 SDK,逼所有功能走同一种模式,并且接受丢掉一部分确定性。
- 变体用参数处理。 不同地区、不同客户、不同数据源,都是同一个 agent 的参数。
- 人只看机器拿不准的。 自动化评估把大多数情况分掉,人工复核留给模糊地带。
- 先在确定的 workflow 里证明价值,再放开自主。
- 透明是基础设施。 先澄清、展示进度、每个结论带引用。
很多团队还在比谁的 agent 多。Harvey 的经验正好反过来:
真正能扩展的,是那个大家共享的大脑,和守在它门口的 eval。
参考资料
Harvey 官方技术博客(按推荐顺序):
- Principles That Helped Us Scale Agent Development(2025 年 11 月):三个目标、三条原则、Tool Bundle、eval 门禁
- Using Agents to Scale Harvey’s Knowledge Sources(2026 年 2 月):一个 agent 加参数化 tools、评估流水线
- Introducing Harvey Agents(2025 年 3 月):agent 的分层定义、workflow、Thinking States
- Integrating Deep Research into Harvey(2025 年 7 月):Workflow Engine、透明原则、引用系统
- A More Unified Harvey Experience(2025 年 7 月):界面合并、先扩再收
- Harvey Raises at $11 Billion Valuation:25,000 多个 custom agent 的出处
外部分析:
- ZenML Case Study:对第 1 篇的第三方总结,附带批评
文中图片均来自 Harvey 官方博客,版权归 Harvey 所有。标为「我的理解」的部分是我自己的分析,不代表 Harvey 的说法。